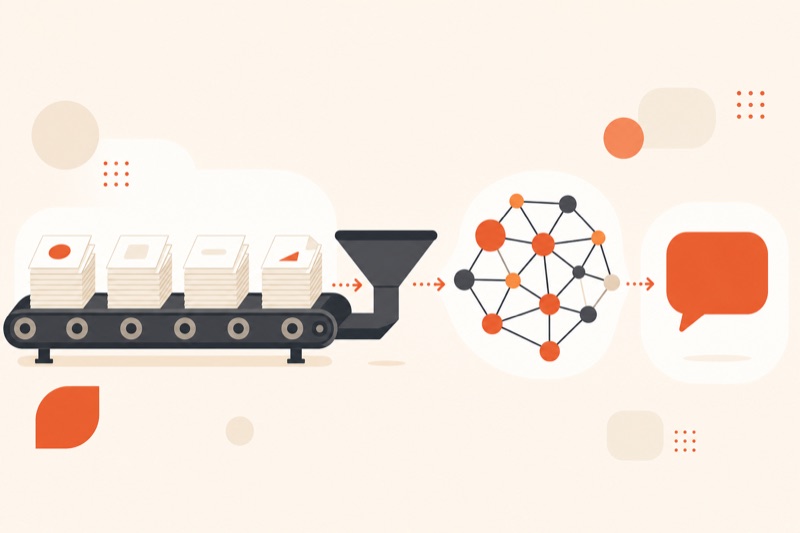
Процесс обучения нейросети выглядит так: сбор данных, долгое предобучение, дообучение с участием людей и только потом работа с вашими сообщениями. Никакого чтения интернета в тот момент, когда вы задаёте вопрос, не происходит: всё, что модель умеет, заложено заранее. Ниже каждый этап простыми словами, без формул, и главное: что из этого меняет вашу повседневную работу с ChatGPT, Claude и Gemini.
У обучения нейросети два разных смысла
Одним словом называют две непохожие вещи. Первая: инженеры компании создают модель, тратят на это месяцы и огромные вычислительные мощности, а готовый результат выкладывают в приложение и API. Вторая: человек осваивает работу с уже готовой моделью, учится ставить ей задачи и встраивать её в свои дела.
Второй путь описан в руководстве про освоение работы с нейросетями на практике. Здесь речь про первое: как модель становится тем, чем вы пользуетесь. Знание этой кухни экономит время, потому что объясняет, почему модель уверенно рассказывает неправду про свежие события и почему ваши поправки в чате не запоминаются навсегда.
Четыре этапа: путь модели до вашего чата
Весь процесс укладывается в четыре шага. Первые три проходят до релиза, у вас на глазах идёт только четвёртый.
- Сбор данных. Тексты, код, изображения и другие материалы собирают в один большой корпус и чистят от мусора, дублей и запрещённого содержимого.
- Предобучение. Модель миллиарды раз пытается угадать следующий кусочек текста и после каждой попытки немного меняет внутренние числа (веса), чтобы в следующий раз ошибиться меньше.
- Дообучение. Люди показывают модели образцовые ответы и оценивают её собственные, и по этим оценкам её приучают решать задачу, а не просто продолжать текст.
- Инференс. Обученную модель замораживают и открывают к ней доступ. Ваш диалог это уже инференс: модель считает ответ, но сама при этом не меняется.
Учиться проще, когда уже видели результат. Завтра в 12:00 МСК на бесплатном мастер-классе ИИ-агент на ваших глазах выполняет задачу целиком, а в Claude Code за эфир собирают работающий сервис.
Посмотреть бесплатноПредобучение: откуда у модели знания
На этом этапе модели показывают гигантский объём текста и ставят одну задачу: предсказать, какой фрагмент идёт следующим. Никто не размечает вручную «вот правильный ответ про фотосинтез». Модель просто предсказывает продолжение снова и снова, а из миллиардов таких попыток постепенно складывается умение связно писать, переводить, считать и рассуждать.
Этап самый дорогой из всех. В разборе устройства языковых моделей приводится оценка на примере модели InstructGPT: на предобучение приходится около 98% всех вычислений и данных, а на всё последующее дообучение остаются проценты (разбор RLHF, Chip Huyen). Поэтому новые поколения моделей выходят раз в несколько месяцев, а не каждую неделю.
Откуда берут сами материалы и что из этого применимо к вашему проекту, мы подробно расписали в статье про данные для обучения нейросети.
Результат предобучения ещё не собеседник. Это очень эрудированный продолжатель текста: на строчку «Как сварить борщ?» он может выдать список из десяти похожих вопросов, потому что в интернете такие строчки часто идут подряд. Собеседником модель делает следующий этап.
По теме: Данные для обучения нейросети: откуда берутся и какие нужны вам
Дата отсечки: почему модель не знает про вчера
Данные собирают до определённого момента, и после этого модель сама ничего нового не узнаёт. Этот момент называют датой отсечки знаний, и он честно публикуется в документации.
У Anthropic это разведено на две даты: reliable knowledge cutoff (докуда знания наиболее полные и надёжные) и training data cutoff (более широкий диапазон использованных данных). Например, у Claude Opus 5 надёжная отсечка указана как май 2026, у Claude Sonnet 5 и Claude Fable 5 январь 2026 (документация моделей Claude). У моделей OpenAI и Google даты свои, их тоже пишут в документации.
Вывод практический: отвечать по памяти про свежие цены, версии программ и события модель не должна, а если отвечает, проверяйте. Обойти отсечку можно тремя способами.
- Включить поиск в интернете там, где инструмент это умеет: ответ строится по найденным страницам, и на них можно посмотреть.
- Дать факты прямо в сообщении: вставить кусок документа, прайс или статью и попросить работать только с ними.
- Спрашивать о методе, а не о факте: «как проверить», «на что смотреть», «какой порядок действий». Такие ответы устаревают медленнее любых цифр.
Теория оживает, когда агент работает на ваших глазах. Завтра в 12:00 МСК на бесплатном мастер-классе ему ставят задачу голосом, он сам находит данные и сводит их в Google-таблицу, а в Claude Code за эфир проходят путь от идеи до сервиса.
Занять местоДообучение: как из продолжателя текста получается собеседник
Второй большой этап называют дообучением, или post-training. Классическую схему OpenAI описала на примере модели InstructGPT, и в ней три шага: сначала люди пишут образцовые ответы и на них дообучают модель, потом люди сравнивают пары ответов и выбирают лучший, на этих сравнениях обучается отдельная модель наград, а затем основную модель подтягивают так, чтобы её ответы получали оценку выше (работа OpenAI об обучении с обратной связью от людей).
Этот же этап отвечает за вежливый тон, отказы от опасных тем и привычку структурировать ответ. И он же во многом объясняет выдумки. В исследовании OpenAI «Why language models hallucinate» показано, что привычные способы обучения и проверки моделей поощряют угадывание: за ответ «не знаю» баллов не дают, а угаданный вариант иногда попадает в цель, поэтому модели выгоднее рискнуть (исследование OpenAI).
Рабочая привычка: сразу спрашивать «на чём основан ответ и насколько ты уверен». Там, где источника нет, модель обычно начинает оговариваться уже на этом шаге, и выдумка ловится до того, как попадёт в вашу работу.
По теме: Модели обучения нейросетей: как ИИ учится простыми словами 2026
Инференс: что происходит, когда вы нажимаете «отправить»
В момент диалога обучения нет вообще. Ваш текст разбивается на токены (кусочки слов), проходит через уже готовые веса, и модель получает вероятности для следующего токена. Она выбирает один, дописывает его к ответу и повторяет всё заново, пока ответ не закончится. Отсюда три следствия, заметные в работе каждый день.
- Один и тот же вопрос даёт разные ответы: выбор следующего токена не строго предопределён, и это нормальное поведение, а не сбой.
- Между чатами модель сама по себе ничего не помнит. В новом диалоге она видит только то, что вы туда положили, плюс отдельные функции памяти и проектов, если вы их включили.
- Всё, что участвует в ответе, должно поместиться в контекстное окно. Сколько это в цифрах и как считается расход, описано в руководстве про токены и контекстное окно.
И главное: ваши сообщения не меняют веса модели. Даже если вы десять раз поправили её в одном чате, в новом диалоге она начнёт ровно с того же места. Причина в устройстве процесса: обучение и работа разнесены по времени.
Что вы меняете на самом деле: контекст, а не веса
Когда говорят «я обучил нейросеть под себя», почти всегда имеют в виду настройку контекста, а не обучение: инструкции, примеры, загруженные файлы, база знаний. Веса при этом остаются неизменными, а поведение модели меняется сильно и предсказуемо. Как это делается по шагам и без кода, описано в руководстве про настройку нейросети под свои задачи.
Отдельный вопрос: попадают ли ваши диалоги в обучение будущих версий. Это уже вопрос политики сервиса, а не текущего чата, и политика у всех разная.
- Anthropic: чаты на тарифах Free, Pro и Max используются для обучения новых моделей, только если включена соответствующая настройка приватности, и это не распространяется на Claude for Work, Claude Gov, Claude for Education и API (условия Anthropic).
- OpenAI: переключатель «Improve the model for everyone» лежит в настройках, в разделе Data Controls. Если его выключить, новые диалоги на обучение моделей не идут (справка OpenAI).
Но даже при включённой настройке это не мгновенное обучение: диалог может попасть в материалы для будущей версии, а не изменить модель, с которой вы говорите сейчас. Правило простое: коммерческие тайны и данные клиентов в обычный чат не отправлять, для такого есть корпоративные тарифы и API.
Частые вопросы
Можно ли обучить нейросеть на своих данных без программиста?
Полноценное изменение весов требует кода, доступа к API и денег на вычисления. Но задача «пусть модель знает мои материалы» почти всегда закрывается проще: загрузкой файлов в проект, постоянной инструкцией в настройках и базой знаний, к которой модель обращается при ответе. Для большинства рабочих сценариев этого хватает.
Сколько времени проходит от сбора данных до релиза модели?
Точные сроки компании не раскрывают, но разрыв виден по датам. У Claude Fable 5 отсечка данных январь 2026, а общий доступ к модели открылся 9 июня 2026 (документация моделей Claude). То есть на дообучение, проверки и подготовку к запуску уходят месяцы.
Почему модель ошибается в простых фактах, если училась на огромном объёме текста?
Потому что внутри у неё не список фактов, а статистика языка: там, где точного знания нет, выдаётся правдоподобное продолжение. Плюс сами способы проверки моделей поощряют угадывание вместо признания незнания (исследование OpenAI). Помогают источники прямо в сообщении и проверка ответа, споры с моделью не помогают.
Если я исправлю ошибку модели в чате, она это запомнит?
В пределах текущего диалога да: правка лежит в контексте, и дальше модель её учитывает. В новом чате нет, если только вы не сохранили правило в память, в проект или в свою постоянную инструкцию. На веса модели такие поправки не влияют никак.
Понимать, как учится модель, полезно, а применять её каждый день полезнее. На бесплатном мастер-классе разбирают 10 базовых ИИ-сервисов и что делать с ними в работе и в быту, без теории про веса и градиенты.
Записаться на мастер-класс