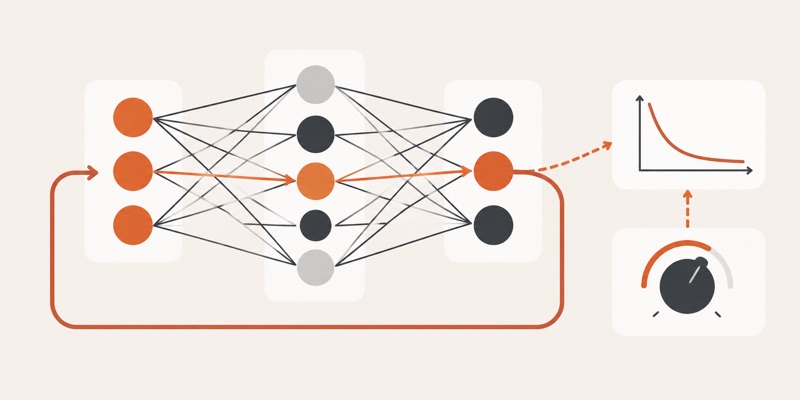
Обратное распространение ошибки вычисляет, как каждый вес нейросети влияет на ошибку: производные функции потерь по каждому обучаемому весу находят от выхода к входу по правилу цепочки. Затем градиентный спуск сдвигает веса против градиента. Для реальной глубокой сети понадобятся данные и программная библиотека; ручной пример нужен для понимания принципа.
Обратное распространение делает градиентный спуск применимым к многослойным нейросетям. Один обучающий шаг проходит в таком порядке:
- Выполните прямой проход. Сеть вычисляет выход и сохраняет промежуточные значения.
- Вычислите функцию потерь по прогнозу и правильному ответу.
- Выполните обратный проход по правилу цепочки от выхода к входу.
- Получите градиенты функции потерь по каждому обучаемому весу.
- Сделайте шаг градиентного спуска по формуле
w ← w − шаг × градиент.
Что происходит до обратного прохода
До обратного прохода сеть вычисляет прогноз и функцию потерь. Сначала задают данные, правильный ответ и способ измерить расхождение. Модель последовательно преобразует вход, получает прогноз и сохраняет промежуточные значения для вычисления градиентов. Этот этап называют прямым проходом. В PyTorch autograd одновременно вычисляет результат операции и сохраняет её функцию градиента в вычислительном графе. Функция потерь сравнивает прогноз с правильным ответом. Автоматическое дифференцирование в PyTorch связывает эти вычисления с последующим обратным проходом.
Слово «ошибка» здесь обозначает измеренную функцией потерь величину, а не обязательно одну неверную метку. Для разных задач выбирают разные функции потерь. Поэтому нельзя оценивать обучение только по тому, что отдельный ответ «выглядит правильно»: сначала определите, какое число модель должна уменьшать на ваших данных. В разборе всего процесса обучения нейросети эти этапы связаны с подготовкой данных и проверкой результата.
Учиться проще, когда уже видели результат. Завтра в 12:00 МСК на бесплатном мастер-классе ИИ-агент на ваших глазах выполняет задачу целиком, а в Claude Code за эфир собирают работающий сервис.
Посмотреть бесплатноПочему расчёт идёт от выхода к входу
Градиенты вычисляют от выхода к входу: вес последнего слоя непосредственно влияет на прогноз, а для веса раннего слоя нужно учесть цепочку промежуточных изменений до функции потерь. Правило цепочки в PyTorch позволяет передать влияние ошибки назад через слои и получить градиент для каждого обучаемого веса. Это и называют обратным распространением. Само изменение весов выполняет отдельный шаг оптимизации.
На каждом узле вычислений градиент, пришедший со стороны выхода сети, называют upstream gradient. Его умножают на локальную производную узла: входящий градиент × локальная производная. Результат, который уходит к предыдущему узлу, называют downstream gradient. Так вычисляют влияние раннего веса через все последующие операции, когда его изменение сначала меняет промежуточное значение и только затем влияет на потери. Для нейрона со смещением z = w · x + b производная z по b равна 1, поэтому градиент смещения равен dL/dz. В расчётах ниже смещения нет.
Не смешивайте два действия: обратный проход вычисляет, в какую сторону и насколько чувствительна ошибка к весам; оптимизатор решает, как обновить веса.
По теме: Алгоритм обучения нейросети: как это работает простыми словами 2026
Можно ли увидеть это на маленьком примере
Да. Возьмите учебную модель без скрытого слоя: прогноз равен входу, умноженному на один вес. Пусть вход равен 2, правильный ответ 4, начальный вес 1, а потери равны квадрату разности прогноза и ответа. Это не полноценная глубокая сеть, но её один обучающий шаг показывает смысл градиента без установки программ. Все числа далее относятся только к этому примеру.
- Прямой проход:
2 × 1 = 2. Прогноз равен 2. Потери:(2 − 4)² = 4. - Производная потерь по весу для этой формулы равна
2 × (прогноз − ответ) × вход. Подстановка даёт2 × (2 − 4) × 2 = −8. Отрицательный знак говорит, что для уменьшения потерь вес стоит увеличить. - Возьмите учебный шаг
0,1и обновите вес:1 − 0,1 × (−8) = 1,8. Новый прогноз:2 × 1,8 = 3,6. Новые потери:(3,6 − 4)² = 0,16. - Сравните потери до и после. Здесь они уменьшились с 4 до 0,16. Повторение такого расчёта с новыми весами составит следующую итерацию обучения.
Для обучения не требуется выбирать наибольший градиент. Направление обновления идёт против градиента, а величину изменения веса задаёт произведение шаг обучения × градиент. Повторите расчёт с шагом 0,5: вес станет 5, прогноз 10, а потери 36. Большой шаг ухудшил результат, хотя градиент был вычислен верно. Это показывает, зачем следить за размером шага, а не считать любое изменение весов улучшением. При слишком высоком шаге модель не сходится и колеблется вокруг значений весов, при которых потери минимальны, как объясняет Google в разделе о размере шага.
Как посчитать градиенты через скрытый нейрон
Через скрытый нейрон градиент проходит по тому же правилу цепочки: производные последовательно перемножают от потерь к входу. Возьмите сеть с входом x = 2 и правильным ответом t = 4. Скрытый нейрон вычисляет h = ReLU(w1 · x). ReLU оставляет положительное значение без изменения и возвращает 0 для отрицательного. Выход сети равен y = w2 · h, потери задаёт L = (y − t)². Начальные веса: w1 = 0,5, w2 = 1; шаг обучения 0,05. Теперь нужно вычислить градиенты по обоим весам.
- На прямом проходе получите
z = 0,5 × 2 = 1,h = ReLU(1) = 1,y = 1 × 1 = 1. Потери:L = (1 − 4)² = 9. - Начните обратный проход от потерь к выходу:
dL/dy = 2 × (1 − 4) = −6. Градиент по выходному весу:dL/dw2 = dL/dy × h = −6. - Передайте градиент в скрытый слой:
dL/dh = dL/dy × w2 = −6. Приz > 0производная ReLU равна1, поэтомуdL/dz = −6. Градиент по первому весу:dL/dw1 = dL/dz × x = −12. - Обновите оба веса по полученным градиентам:
w2 = 1 − 0,05 × (−6) = 1,3,w1 = 0,5 − 0,05 × (−12) = 1,1. На новом прямом проходеh = 2,2,y = 2,86, а потери(2,86 − 4)² = 1,2996вместо 9.
В этом расчёте dL/dy приходит на узел умножения как upstream gradient, а локальная производная выхода по h равна w2, поэтому к скрытому нейрону уходит downstream gradient dL/dh = dL/dy × w2. На узле ReLU уже dL/dh становится входящим градиентом. Названия зависят от того, какой узел вы сейчас рассматриваете.
Проверьте производную по w1 численно: CS231n рекомендует центральную разность (L(w + ε) − L(w − ε)) / (2ε). Она даёт те же −12, что и ручной обратный проход. Следующий код на Python повторяет расчёт без сторонних библиотек, сравнивает аналитический градиент с численным и выводит прогноз и потери перед каждым обновлением. Все градиенты вычисляются до изменения весов, чтобы обратный проход использовал значения того же прямого прохода.
x, t = 2.0, 4.0          # вход и правильный ответ
w1, w2 = 0.5, 1.0        # начальные веса
lr = 0.05                # шаг обучения

def loss_fn(w1, w2):
    h = max(w1 * x, 0.0)  # скрытый нейрон с ReLU
    return (w2 * h - t) ** 2

for step in range(5):
    z = w1 * x
    h = max(z, 0.0)
    y = w2 * h
    loss = (y - t) ** 2
    dy = 2 * (y - t)                    # dL/dy
    dw2 = dy * h                        # dL/dw2
    dz = dy * w2 * (1.0 if z > 0 else 0.0)  # назад через ReLU
    dw1 = dz * x                        # dL/dw1
    if step == 0:                       # проверка градиента численно
        eps = 1e-5
        num = (loss_fn(w1 + eps, w2) - loss_fn(w1 - eps, w2)) / (2 * eps)
        print(f"dw1 аналитически {dw1:.4f}, численно {num:.4f}")
    print(f"шаг {step}: прогноз {y:.4f}, потери {loss:.4f}")
    w1 -= lr * dw1
    w2 -= lr * dw2
Вывод для пяти последовательных проходов:
dw1 аналитически -12.0000, численно -12.0000
шаг 0: прогноз 1.0000, потери 9.0000
шаг 1: прогноз 2.8600, потери 1.2996
шаг 2: прогноз 4.3311, потери 0.1096
шаг 3: прогноз 3.7733, потери 0.0514
шаг 4: прогноз 4.1257, потери 0.0158
Потери перед обновлениями идут в таком порядке: 9 → 1,2996 → 0,1096 → 0,0514 → 0,0158. На третьем проходе прогноз 4,3311 перескакивает правильный ответ, а на следующем возвращается ниже него. При каждом повторении прямой проход использует новые веса, после чего обратный проход заново вычисляет градиенты.
Теория оживает, когда агент работает на ваших глазах. Завтра в 12:00 МСК на бесплатном мастер-классе ему ставят задачу голосом, он сам находит данные и сводит их в Google-таблицу, а в Claude Code за эфир проходят путь от идеи до сервиса.
Занять местоКак это выглядит в реальном коде
В PyTorch обратный проход вызывают через loss.backward(), а параметры обновляют через optimizer.step(). Обычно вы не выписываете производные каждого слоя вручную, потому что библиотеки автоматического дифференцирования строят вычислительную цепочку и находят градиенты для всех обучаемых параметров модели. PyTorch по умолчанию накапливает их: новый вызов .backward() добавляет вычисленные значения в .grad, как описывает документация autograd. В учебном цикле сначала очищают накопленные градиенты, затем вызывают обратный проход по потерям и только после этого обновляют параметры. optimizer.zero_grad() сбрасывает градиенты от прошлого обратного прохода и не меняет сами веса; их меняет optimizer.step(). Такой порядок задан в официальном уроке PyTorch.
optimizer.zero_grad(): очистить градиенты перед шагом.loss.backward(): вычислить градиенты для обучаемых параметров.optimizer.step(): обновить параметры выбранным оптимизатором.
import torch

x, t = torch.tensor(2.0), torch.tensor(4.0)
w1 = torch.tensor(0.5, requires_grad=True)
w2 = torch.tensor(1.0, requires_grad=True)
optimizer = torch.optim.SGD([w1, w2], lr=0.05)

for step in range(5):
    y = w2 * torch.relu(w1 * x)   # прямой проход
    loss = (y - t) ** 2
    optimizer.zero_grad()         # сбросить прошлые градиенты
    loss.backward()               # обратный проход
    if step == 0:
        print(w1.grad.item(), w2.grad.item())  # -12.0 -6.0
    optimizer.step()              # шаг градиентного спуска
    print(step, round(loss.item(), 4))
На первом проходе значения w1.grad и w2.grad равны -12.0 и -6.0, как в ручном расчёте. Потери по проходам совпадают с примером без библиотек. Строка с потерями печатает значение, рассчитанное до optimizer.step(); следующий прямой проход считает их уже с обновлёнными весами.
Если вы лишь пользуетесь готовой нейросетью для текста или изображений, выполнять эти операции не требуется. Для выбора между готовым сервисом и самостоятельной настройкой поможет разбор обучения нейросети под себя.
По теме: Машинное обучение и нейросети: в чём разница простыми словами 2026
Как связаны один пример, мини-пакет и эпоха
В учебном расчёте градиент вычисляется по одному примеру, а при мини-пакетном градиентном спуске модель за одну итерацию случайно выбирает несколько примеров, усредняет их градиенты и обновляет веса. Эпоха означает, что каждый пример обучающего набора обработан один раз. Если в наборе 1000 примеров, а в пакете 100, одна эпоха занимает 10 итераций. Определения Google помогают различать повторение шага обновления и проход по всему набору.
В учебной схеме градиентного спуска шаги повторяют, пока модель больше не может уменьшать потери. На каждой итерации заново выполняют прямой и обратный проходы с текущими весами. Алгоритм обучения нейросети связывает эти повторения в общий цикл работы с данными. В обучении с подкреплением градиенты тоже используются, но сигнал для обучения даёт награда, а не правильный ответ.
Почему нельзя начинать с одинаковых весов
Если все нейроны слоя вычисляют один и тот же выход, то на обратном проходе они получают одинаковые градиенты и одинаковые обновления параметров, поэтому так и остаются копиями друг друга и не учатся разным преобразованиям. Веса обычно инициализируют малыми случайными числами, чтобы нарушить эту симметрию. В CS231n это называют symmetry breaking.
По теме: Процесс обучения нейросети: этапы от данных до ответа в чате 2026
Как найти причину, если качество не растёт
Причину отсутствия роста качества ищите в цели, функции потерь, градиентах и обновлении весов. Сначала убедитесь, что сравниваете прогноз с правильной целью и считаете одну и ту же функцию потерь до и после обновления, затем проверьте, изменяются ли вообще обучаемые веса. Если веса стоят на месте, проверьте наличие градиентов и шаг оптимизатора. Если потери резко скачут вверх, уменьшите шаг обучения и наблюдайте кривую потерь.
В глубоких сетях градиенты ранних слоёв могут исчезать: при обратном проходе перемножается много малых множителей, и результат приближается к нулю. Тогда ранние слои обучаются очень медленно или перестают обучаться. ReLU помогает предотвращать исчезающие градиенты: при положительном входе его производная равна 1, и этот множитель не ослабляет сигнал. Google описывает эту проблему для слоёв, расположенных ближе к входу сети.
У сигмоиды локальный градиент равен (1 − σ(x)) σ(x). Его максимум составляет 0,25 при σ(x) = 0,5. Когда выход сигмоиды насыщается около 0 или 1, производная почти равна нулю, поэтому при умножении на этот локальный градиент сигнал к предыдущему слою ослабевает, даже если до узла он был заметным. Именно так насыщение сигмоиды подавляет градиенты.
Взрывающиеся градиенты возникают, когда большие веса приводят к произведению многих больших множителей на обратном проходе. Чрезмерно большие градиенты мешают сходимости: изменения весов становятся нестабильными. Для этой проблемы Google рекомендует уменьшить шаг обучения или использовать batch normalization. Поэтому вместе с кривой потерь смотрите на величину градиентов по слоям: огромные значения указывают на взрыв, близкие к нулю у ранних слоёв на затухание.
В примере со скрытым нейроном при отрицательном z ReLU выдаёт 0, и градиент к w1 не проходит. Нейрон может застрять в таком состоянии, когда изменения на входе не возвращают сумму выше нуля. Google называет это мёртвыми ReLU: при обратном проходе через них больше не течёт градиент. Меньший шаг обучения помогает предотвращать эту проблему; также используют варианты ReLU вроде LeakyReLU.
Для учебного расчёта сохраните исходный вес, прогноз и потери до шага, выпишите градиент и шаг обучения, затем получите новый вес и новые потери. Если конечные потери не уменьшились, проверьте формулу и размер шага, затем повторите с меньшим значением. Если производные выписаны вручную, сопоставьте их с численным градиентом, как в примере выше. Подготовку данных и её связь с обучением объясняет статья о данных для обучения.
Как появился метод обратного распространения
Сеппо Линнаинмаа описал эффективный обратный режим автоматического дифференцирования в магистерской работе 1970 года, ещё без связи с нейросетями. В июне 1976 года вышла его статья «Taylor expansion of the accumulated rounding error» в журнале BIT, DOI 10.1007/BF01931367. Пол Вербос предварительно обсуждал применение к нейросетям в диссертации 1974 года; первое такое применение обзор Юргена Шмидхубера относит к работе Вербоса 1982 года «Applications of advances in nonlinear sensitivity analysis», DOI 10.1007/BFb0006203. В октябре 1986 года Румельхарт, Хинтон и Уильямс опубликовали в Nature статью «Learning representations by back-propagating errors», том 323, страницы 533-536. Они показали, что метод обучает скрытые слои полезным внутренним представлениям. После этой статьи обратное распространение стало широко известно.
Частые вопросы
Обратное распространение и градиентный спуск означают одно и то же?
Нет. Обратный проход получает градиенты, а градиентный спуск использует их, чтобы изменить веса. В учебной задаче эти операции идут рядом, поэтому их часто смешивают.
Нужно ли знать высшую математику, чтобы пользоваться нейросетью?
Для работы с готовым сервисом нет. Для понимания и отладки обучения модели полезны производные и правило цепочки. Google пишет, что понимание и отладка проблем с градиентами обычно требуют базовых знаний математического анализа.
Почему ошибка может вырасти после правильного обратного прохода?
Градиент задаёт локальное направление, но слишком большой шаг обновления способен перескочить область улучшения. Проверьте размер шага и потери на следующих итерациях. О размере шага.
Зачем нужен прямой проход?
Прямой проход вычисляет выход сети и потери при текущих весах и сохраняет промежуточные значения. Без них обратный проход не посчитает градиенты: в примере выше формула dL/dw2 = dL/dy × h требует значения h, полученного на прямом проходе. В PyTorch во время прямого прохода autograd записывает операции в вычислительный граф.
Что делает optimizer.zero_grad()?
Сбрасывает градиенты, накопленные прошлым вызовом loss.backward(). Веса он не меняет, их обновляет optimizer.step(). Без сброса PyTorch сложит новые градиенты со старыми, поэтому в официальном уроке градиенты обнуляют на каждой итерации.
Разберитесь, какие задачи решать готовыми нейросетями, а когда нужен собственный проект с проверкой результата. На мастер-классе покажем базовые ИИ-инструменты и практический путь работы с ними.
Записаться на мастер-класс