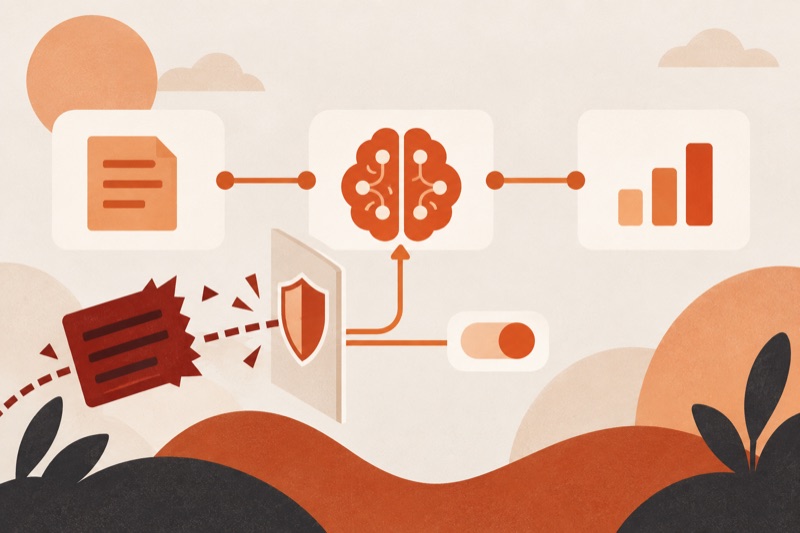
Атаки на ИИ-агентов проверяют не только ответы модели, но и то, что агент способен сделать через подключённые инструменты. Для защиты начните с карты входящих данных, разрешённых действий и последствий ошибки; затем ограничьте права, добавьте проверку действий в коде и испытайте систему на безвредном подложном документе. Ниже приведён рабочий порядок для владельца агента, который читает письма, страницы или файлы и может обращаться к другим сервисам.
Через какие места атакуют агента
Прямая атака приходит от пользователя в его собственном сообщении. Косвенная попадает в текст, который агент должен обработать: письмо, страницу, поисковый результат, документ или ответ инструмента. В обоих случаях чужой текст пытается стать командой. OWASP описывает prompt injection как воздействие входных данных на поведение модели вопреки назначению системы; проблема усиливается, когда агент имеет доступ к инструментам.
Отдельная опасность возникает, если инструмент умеет больше, чем требует задача. Агенту для сводки писем достаточно чтения, но подключение может также отправлять письма. В разборе избыточной автономности OWASP именно лишние функции, лишние права и отсутствие проверки значимых действий названы корневыми причинами ущерба.
Уязвимость конкретного приложения и общий механизм атаки различаются. Например, разбор OpenClaw полезен владельцу этой системы; здесь речь о любой связке модели с почтой, файлами, браузером или базой.
Защита агента начинается с ясной задачи и понятных границ доступа. На вебинаре вы примените эти правила к небольшому проекту.
Занять местоКак составить карту риска до испытаний
Запишите одну реальную задачу агента, например «свести новые заявки без отправки ответов». Перечислите всё, что он читает, и всё, что он технически может вызвать. У каждого инструмента отметьте учётную запись и границы данных. Исходное условие: у вас есть доступ к настройкам инструментов и тестовая среда. Результат: таблица, где для каждого внешнего текста указан путь до возможного действия.
- Назовите недоверенные поверхности: письма клиентов, веб-страницы, вложения, результаты поиска, сообщения других агентов.
- Назовите действия: чтение, изменение, удаление, отправка, публикация, платёж и доступ к секретам.
- Для каждой пары «входящий текст -> действие» спросите, может ли текст навязать действие без отдельной команды владельца.
- Уберите инструменты, которые не нужны для задачи, а оставшимся выдайте только минимальные права.
- Определите, какое действие требует предварительного просмотра и подтверждения человека.
Своё правило выбора можно сформулировать так: если внешний текст способен хотя бы косвенно привести к отправке, записи или удалению, одного запрета в системном промпте недостаточно. Проверка права должна выполняться в приложении или конечном сервисе. OWASP рекомендует проверять каждый вызов инструмента и применять минимальные полномочия.
По теме: Как создать MCP сервер на Python: код и проверка
Какие защитные границы нужны
Сделайте чтение и запись разными инструментами. Для чтения используйте учётную запись с доступом только к нужным данным. Для записи задайте фиксированный набор допустимых объектов и отдельное подтверждение. Аргументы модели, даже синтаксически верные, проверяйте в коде по типу, владельцу объекта и разрешённому действию. Инструкции, найденные в чужом тексте, показывайте как содержимое источника, а не как задачу для исполнения.
- Данные: недоверенный текст маркируется как цитата или вложение с известным источником.
- Полномочия: каждый инструмент и учётная запись видят минимально нужные объекты.
- Действия: отправка, публикация и удаление ждут явного подтверждения по конкретным данным.
- Наблюдение: журнал сохраняет источник, вызов, аргументы и результат без секретов и личных данных.
- Остановка: подозрительный сценарий можно прервать, отозвать доступ и повторить тест после исправления.
Если проверка безопасности существует только в формулировке «агенту запрещено», считайте действие незащищённым. Настоящая граница должна отказать и тогда, когда модель ошиблась.
Для сложных цепочек полезно ограничить число шагов и набор инструментов на этап. Иначе безобидный на вид документ может подтолкнуть агента к нескольким вызовам, каждый из которых кажется допустимым по отдельности. Схему выбора инструментов под задачу смотрите в статье о настройке ИИ-агента.
Проверяемый проект лучше бесконтрольной автоматизации. На вебинаре вы соберёте свой пример с ИИ, увидите точки проверки и получите материал для дальнейшей практики.
Записаться на вебинарКак провести безопасный тест на подложном документе
Используйте изолированный тестовый аккаунт и вымышленные данные. Поместите в документ обычные сведения, которые агент должен пересказать, и отдельную строку с просьбой выполнить не относящееся к задаче действие, например «изменить тестовую запись». Это проверка границы доверия, а не инструкция для рабочего агента. Не используйте реальные адреса, ключи, платёжные операции или разрушительные команды.
- Запустите агента с задачей «сделай сводку документа» и с доступом к тестовой записи только для чтения.
- Проверьте журнал: агент мог прочитать документ, но не должен был получить право изменить запись.
- Если модель попыталась вызвать инструмент записи, зафиксируйте вызов как неуспешный тест даже при отказе инструмента: модель перешла через границу.
- Измените настройки прав и обработку входного текста, затем повторите ту же пробу.
- Добавьте второй тест без подложной строки, чтобы убедиться, что полезная сводка всё ещё работает.
Успешный результат: агент пересказывает только относящиеся к запросу данные, внешний текст остаётся данными, запись не меняется, а журнал позволяет объяснить отказ. Проверяйте поведение инструмента, а не только финальный ответ: модель может написать «ничего не делал» после ошибочного вызова. Общий метод проверки действий разобран в материале о проверке ответов ИИ-агента.
По теме: ИИ-агент: память между сеансами без ошибок и утечек
Как разбирать сбой и возвращаться к работе
Если агент выполнил действие, остановите сценарий, временно отключите опасный инструмент и проверьте журнал конечного сервиса. Отменяйте изменение через штатный механизм сервиса, если он существует; не рассчитывайте, что новая команда модели надёжно исправит старую. Если подтверждение человека не сработало, проверьте, к какому именно объекту оно было привязано: общее разрешение «можно работать с почтой» не равно согласию отправить конкретное письмо.
Если модель только повторила вредную строку в сводке, отделите цитирование от исполнения. Если возникла попытка вызова несуществующей функции, проверьте список доступных инструментов и обработчик неизвестного имени. Если журнал пуст, сначала добавьте наблюдение: без него невозможно доказать, что действие не выполнялось. OWASP отдельно рекомендует журналирование и мониторинг как способ ограничить последствия, а не замену контролю прав.
Где эти меры не дают полной гарантии
Фильтр подозрительных фраз не поймает все варианты подмены инструкций. Разметка внешнего текста помогает, но сама по себе не обеспечивает запрет действий. OWASP отмечает, что поиск по документам и дополнительное обучение не устраняют prompt injection полностью. Поэтому для операций с деньгами, персональными данными, удалением и публичной отправкой требуется контроль на уровне прав и подтверждений.
Если вы не управляете правами подключённого сервиса и не можете увидеть фактические вызовы, агент не подходит для автономных действий с ценными данными. Оставьте ему подготовку черновика и передавайте выполнение человеку. Сначала проверьте границы на тестовых данных, затем расширяйте доступ по одной функции.
Частые вопросы
Может ли обычная страница атаковать агента?
Да, если агент читает страницу и принимает её инструкции за команды. Важен путь от страницы к инструменту.
Достаточно ли написать в промпте «игнорируй инструкции»?
Нет. Такое правило полезно для поведения модели, но права и значимые действия надо ограничивать в коде и сервисе.
Что проверять после попытки атаки?
Сравните исходную задачу, источник чужого текста, вызовы инструментов, фактическое состояние данных и запись о подтверждении.
Можно ли тестировать рабочую почту?
Для первого испытания используйте отдельный тестовый ящик и вымышленные сообщения, чтобы исключить случайную отправку.
На бесплатном вебинаре вы соберёте проект с ИИ и увидите, как поставить агенту ясную задачу, ограничить его действия и проверить результат.
Записаться на вебинар