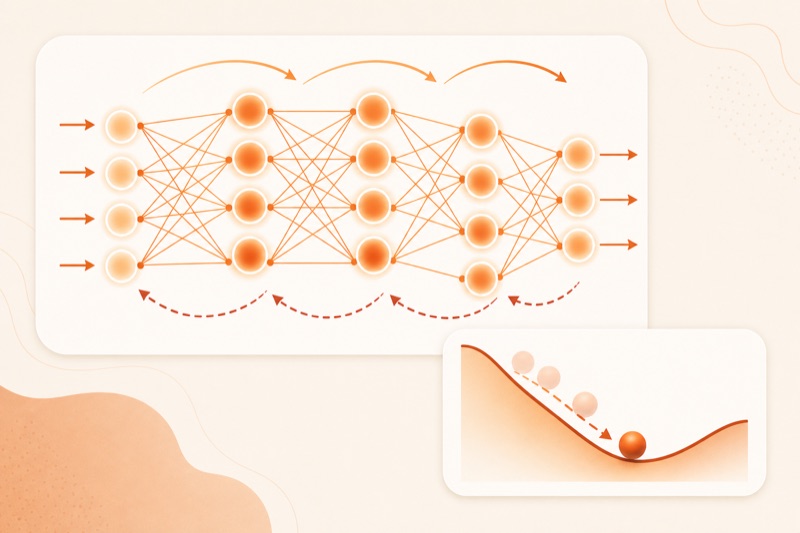
Нейросеть обучается не так, как человек читает учебник. Никто не вписывает в неё правила вручную. Ей показывают тысячи примеров, она пытается угадать ответ, ошибается, а потом чуть-чуть подкручивает свои внутренние настройки, чтобы в следующий раз ошибиться меньше. Повторите этот цикл миллионы раз, и из хаоса чисел получается модель, которая распознаёт лица или пишет текст. Этот алгоритм описывается по шагам, без формул, но и без упрощений, которые превратились бы в неправду. А в конце станет понятно, почему вам самим обучать нейросеть с нуля не нужно.
Что значит «обучить нейросеть»
Внутри нейросети есть параметры, которые называют весами. Вес показывает, насколько один сигнал важен для итогового ответа, и записывается одним числом. Сначала все веса случайные, поэтому необученная сеть выдаёт бессмыслицу. Обучение называют процессом поиска таких значений весов, при которых сеть перестаёт ошибаться на примерах, которые ей показывают.
Представьте пульт с миллионами ручек громкости. Каждая ручка соответствует одному весу. Обучить сеть, значит найти положение всех ручек, при котором звук чистый. Ручки при этом крутит алгоритм, а не человек, и делает это автоматически, ориентируясь на величину ошибки.
Данные и веса: с чего всё начинается
Обучение начинается с данных. Для распознавания кошек нужны тысячи фотографий, часть из которых подписана «кошка», а часть «не кошка». Такие подписи называют разметкой. Качество и количество данных важнее хитрости самой сети: на грязных или однобоких данных даже сложная модель научится плохому.
Данные делят минимум на две части. На обучающей выборке сеть тренируется, а на отложенной проверочной, которую она во время тренировки не видит, проверяют, научилась ли она чему-то полезному или просто зазубрила примеры. Если хотите сначала уложить базовые понятия, помогает разбор, где мы объясняем что такое нейросети простыми словами.
Шесть шагов к вайбкодингу с нуля, без кода и английского, покажут завтра в 12:00 МСК на бесплатном мастер-классе. После эфира понятно, с чего начать уже на следующий день.
Записаться бесплатноОдин шаг обучения: прямой проход, ошибка, обратный проход
Сердце всего алгоритма составляет повторяющийся цикл из нескольких действий. Один такой круг выглядит так:
- Прямой проход. Пример (например, картинку) подают на вход, сигнал проходит сквозь слои сети, и на выходе получается предсказание: скажем, «кошка с вероятностью 0,7».
- Функция потерь. Предсказание сравнивают с правильным ответом и считают, насколько сильно сеть ошиблась. Это число называют ошибкой или потерей: чем оно больше, тем хуже ответ.
- Обратное распространение ошибки. Алгоритм backpropagation идёт от выхода к входу и для каждого веса вычисляет, насколько именно он виноват в этой ошибке.
- Градиентный спуск. Зная вклад каждого веса, алгоритм чуть сдвигает все веса в сторону, которая уменьшает ошибку. Один маленький шаг вниз по «склону» ошибки.
Ключевая пара здесь: обратное распространение ошибки и градиентный спуск. Backpropagation позволяет эффективно посчитать, как изменение каждого веса повлияет на итоговую ошибку, продвигая производные от выходного слоя к входному (объяснение IBM). А градиентный спуск служит самим методом оптимизации: он использует наклон (градиент) поверхности ошибки, чтобы двигать веса туда, где потеря меньше.
Насколько большой шаг делать за раз, задаёт отдельная настройка, скорость обучения. Слишком большой шаг, и сеть перепрыгивает нужную точку и не сходится. Слишком маленький, и обучение тянется бесконечно долго.
По теме: Обратное распространение ошибки в нейросети: простыми словами и с расчётом
Эпохи: почему обучение это повторение
За один проход по данным сеть почти ничему не научится: шаги слишком маленькие. Поэтому весь набор примеров прогоняют через сеть много раз. Один полный проход по всей обучающей выборке называют эпохой.
Цикл «прямой проход, ошибка, обратный проход, сдвиг весов» повторяют эпоху за эпохой, и ошибка постепенно снижается, пока не выйдет на плато (как описывают этот процесс инженеры). Обычно веса обновляют не после каждого примера и не после всех сразу, а небольшими порциями, батчами: так обучение идёт и быстрее, и стабильнее.
Важный риск: переобучение. Если гонять сеть по одним и тем же данным слишком долго, она начинает зазубривать конкретные примеры вместо общих закономерностей. На знакомых картинках она отвечает идеально, а на новых проваливается. Именно для ловли этого и нужна отложенная проверочная выборка.
Теория оживает, когда агент работает на ваших глазах. Завтра в 12:00 МСК на бесплатном мастер-классе ему ставят задачу голосом, он сам находит данные и сводит их в Google-таблицу, а в Claude Code за эфир проходят путь от идеи до сервиса.
Занять местоТри способа учить: с учителем, без учителя, с подкреплением
То, что мы описали выше, это классическое обучение с учителем. Но подходов три, и различаются они тем, есть ли у данных правильные ответы и откуда сеть берёт обратную связь (разбор Яндекс Практикума).
- С учителем. Данные размечены: у каждого примера есть правильный ответ. Сеть учится повторять его. Так делают распознавание объектов, спам-фильтры, прогнозы.
- Без учителя. Ответов нет, сеть сама ищет структуру в данных: группирует похожие объекты, находит закономерности. Так строят рекомендации и сжимают данные.
- С подкреплением. Готовых ответов нет, но есть оценка действий: за удачные ходы награда, за неудачные штраф. Сеть пробует и запоминает, что приносит больше награды. Так учат игровых ботов и роботов.
Разница между этими режимами и более широким полем машинного обучения, тема отдельная: если интересно, мы разбираем, чем машинное обучение отличается от нейросетей.
Простое правило, которое экономит месяцы: сначала сформулируйте задачу и найдите данные, и только потом думайте про модель. Нейросеть без хороших данных не спасёт даже самый модный алгоритм.
По теме: Модели обучения нейросетей: как ИИ учится простыми словами 2026
Что это значит для вас на практике
Чтобы пользоваться нейросетями, весь этот алгоритм проходить самому не нужно. Большие модели вроде Claude или GPT уже обучены. Их сначала предобучают на огромных объёмах текста, где задача одна, предсказать следующее слово, а потом дообучают на обратной связи от людей, чтобы модель отвечала полезно и по делу (как обучают такие модели). На это ушли месяцы работы и очень дорогое оборудование.
Вам достаётся готовый результат. Вместо обучения весов вы управляете моделью словами, то есть промптом. По сути хороший запрос, это ваш способ «настроить» уже обученную сеть под конкретную задачу без единой строки кода. Как формулировать такие запросы, мы показываем в разборе, как писать промпт для нейросети.
Именно на этом стоит вайбкодинг: вы описываете словами, что хотите получить, а обученная модель превращает описание в сайт, бота или приложение. Понимание алгоритма обучения тут полезно как общая грамотность, а не как навык, который придётся применять руками. С чего начать знакомство с самими нейросетями, разложено по шагам в руководстве с чего начать обучение нейросетям.
Частые вопросы
Нужно ли знать математику, чтобы обучить нейросеть?
Чтобы разрабатывать модели с нуля, да: без линейной алгебры и производных не обойтись. Но чтобы применять готовые нейросети для работы и заработка, математика не нужна вообще, достаточно уметь ясно ставить задачу.
Сколько данных нужно для обучения?
Зависит от задачи: от нескольких тысяч примеров для простой классификации до триллионов слов для больших языковых моделей. Универсального числа нет, но правило простое: чем сложнее задача, тем больше и чище должны быть данные.
Что такое обратное распространение ошибки простыми словами?
Это способ разобраться, кто виноват в ошибке. Сеть посчитала ответ, ошиблась, и алгоритм идёт от выхода назад, распределяя вину по всем весам: этот повлиял сильно, тот слабо. После этого каждый вес поправляют пропорционально его вкладу.
Можно ли дообучить готовую модель под себя?
Да, это называют дообучением или fine-tuning: берут уже обученную модель и подкручивают её на своих данных. Но обычно это лишнее, грамотного промпта и загрузки нужных материалов в диалог хватает.
Нейросеть продолжает учиться, когда я ей пользуюсь?
Обычно нет. Модель, которую вы используете, уже обучена, и её веса зафиксированы. Она помнит контекст текущего диалога, но не меняет свои внутренние параметры от ваших сообщений. Дообучение запускают отдельным управляемым процессом, само собой оно не происходит.
Теперь вы понимаете, как модели учатся. На бесплатном мастер-классе покажем обратную сторону: как применять уже обученные нейросети, чтобы делать сайты и ботов и зарабатывать на этом, без кода и без обучения моделей.
Занять место